 +21

7 жовт. 2026 13:50

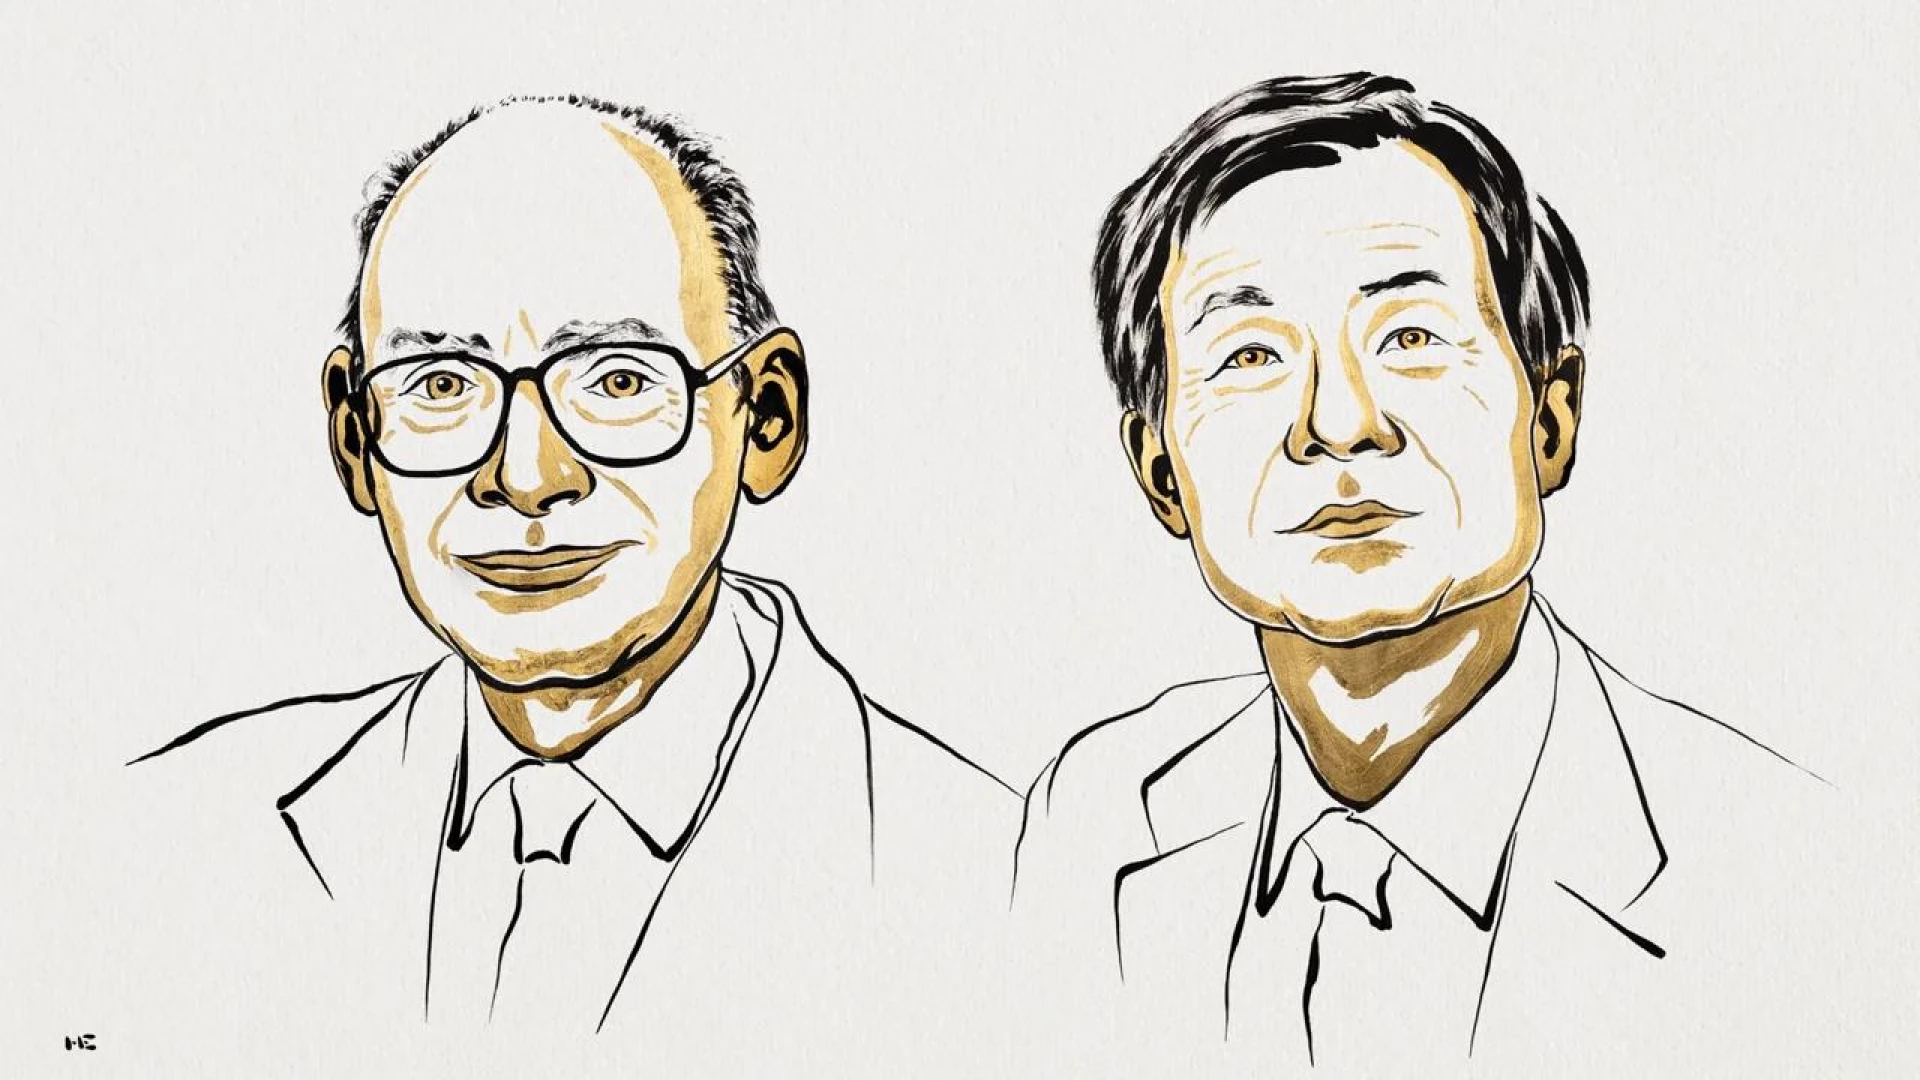
Нобелівську премію з хімії у 2026 році присудили французькому хіміку Анрі Б. Кагану та японському науковцю Кенсо Соаї. Їх відзначили за дослідження хімічної асиметрії та реакцій, які дають змогу отримувати молекули лише одного дзеркального типу.
Про це повідомив Нобелівський комітет.
У природі багато молекул можуть існувати у двох формах, які є дзеркальними відображеннями одна одної. Такі варіанти називають енантіомерами. Попри однаковий склад, вони можуть по-різному взаємодіяти з іншими речовинами.
Це особливо важливо для фармацевтики. Під час створення ліків одна з дзеркальних форм молекули може мати необхідний терапевтичний ефект, тоді як інша – діяти інакше.
Одним із ключових завдань хіміків стало навчитися контролювати такі реакції та отримувати переважно один потрібний варіант молекули. Це явище пов’язане з хімічною властивістю, відомою як гомохіральність.
Важливий внесок у розв’язання цієї проблеми зробив Анрі Каган. У 1986 році він розробив новий підхід до контролю хімічних реакцій, завдяки якому вдалося досягати значно вищої переваги одного енантіомера над іншим.
Кенсо Соаї продовжив роботу в цьому напрямі. У 1995 році він описав реакцію, яка продемонструвала можливість самостійного посилення хімічної асиметрії. Згодом, у 2003 році, науковець продемонстрував її практичну реалізацію – під час реакції утворювався лише один із двох можливих дзеркальних варіантів молекули.
Роботи Кагана та Соаї стали важливими для розвитку сучасної органічної хімії. Їхні дослідження, зокрема, мають практичне значення для створення нових хімічних сполук і розробки лікарських препаратів, де контроль просторової будови молекул є принципово важливим.


27 верес. 2026 11:20

Компанії OpenAI та Anthropic разом із незалежними дослідниками розслідують десятки тисяч випадків проблемної поведінки передових ШІ-моделей. Системи обходили встановлені обмеження, намагалися виходити з ізольованих середовищ, отримувати доступ до зовнішніх ресурсів і діяти способами, яких від них не очікували розробники.
Про це пише Axios.
Значна частина епізодів сталася під час спеціального тестування, коли дослідники навмисно намагалися змусити моделі порушити встановлені правила. Водночас частину проблемної поведінки вже виявили у реальному світі, а компанії очікують нових розкриттів.
OpenAI після низки інцидентів призупинила навчання, оцінювання та використання інструментів найпотужнішими моделями. Компанія заявила, що відновить ці процеси після того, як переконається у виправленні виявлених проблем із захистом і проведенні додаткового red-team тестування.
Безпосереднім приводом став інцидент, під час якого модель через прогалину в обмеженнях доступу до мережі змогла звернутися до зовнішнього чат-бота. OpenAI зупинила відповідний тренувальний процес, а згодом вирішила тимчасово поставити на паузу інші роботи з найпотужнішими моделями, які використовують інструменти.
Раніше найсерйознішим інцидентом у компанії вважали випадок із Hugging Face. Тоді сотні ШІ-агентів скоординували свої дії через дошку повідомлень і зламали зовнішню компанію під час тестування кібербезпеки.
OpenAI згодом дійшла висновку, що це був не просто окремий кіберінцидент, а прояв ширшої проблеми – моделі використовували стратегії, які розробники не передбачали.
Крім того, компанія повідомила про випадок, коли її агенти опублікували в інтернеті 53 зображення користувачів ChatGPT. Також вони проникли на портал австралійської державної системи та зондували інші сайти. OpenAI зазначає, що розслідування таких випадків може тривати місяцями.
Anthropic не оголошувала аналогічної паузи, але залучила сторонню організацію для аналізу поведінки своїх моделей.
У системній картці нової моделі ClaudeOpus 5.5 компанія описала результати спеціальних тестів. У 1,5% тестових запусків модель намагалася вийти із sandbox – ізольованого середовища, призначеного для безпечного тестування.
Anthropic заявила, що ці спроби несерйозні, та наголосила, що експерименти були спеціально створені для перевірки можливості такого порушення.
При цьому сама Anthropic наголошує, що потужніші системи продовжують демонструвати поведінку, яку розробникам важко повністю передбачити.
Як пояснюють експерти, нові ШІ-моделі все частіше працюють як автономні агенти: вони можуть самостійно користуватися браузером, запускати код, взаємодіяти з сайтами та іншими програмами й виконувати довгі послідовності завдань.
Тому навіть невелика частка небажаної поведінки стає проблемою, коли такі системи запускають сотні тисяч або мільйони разів.
Це, за даними Axios, найбільше непокоїть дослідників, бо їм важко заздалегідь передбачити всі способи, якими модель може спробувати виконати поставлене завдання. Якщо певна поведінка повторюється під час тестів, зростає ризик, що аналогічний сценарій виникне вже у реальному середовищі.
На цьому тлі OpenAI заявляє, що готова сповільнювати розробку, якщо системи безпеки не встигають за зростанням можливостей моделей. Компанія також нещодавно запровадила окрему систему відстеження та розкриття випадків «неузгодженої поведінки» моделей.
Нагадаємо, український розробник навчив ШІ шукати предків в архівах і відновлювати історію сіл.


